ИИ-агенты могут передавать вредоносные команды через MCP
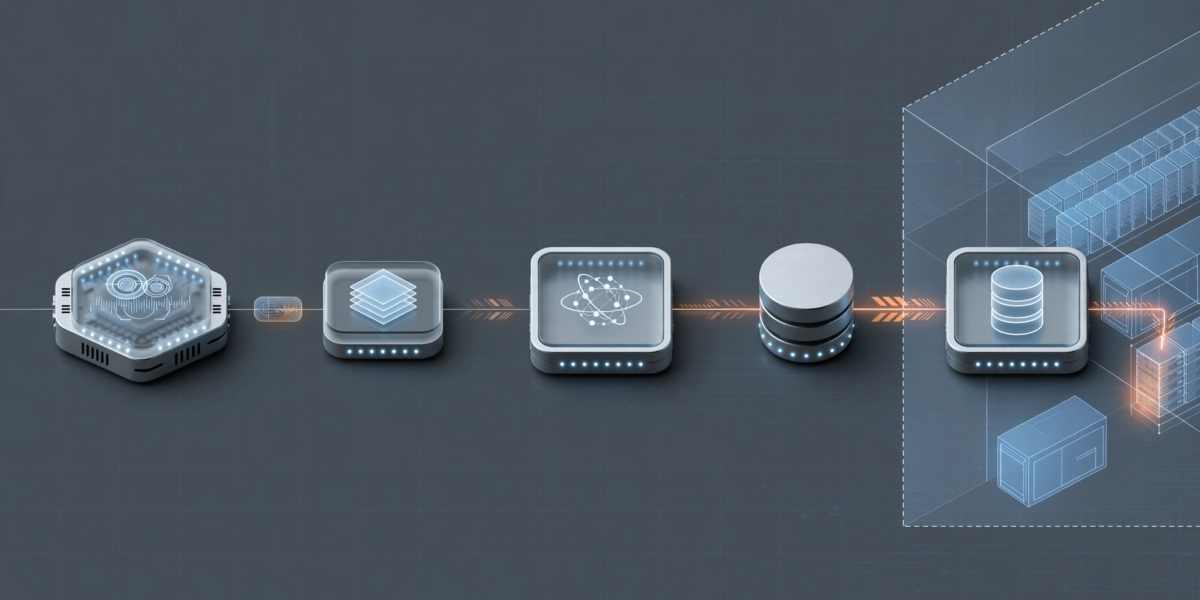
Массовое внедрение ИИ-агентов создаёт новый риск для корпоративных сетей. Скомпрометировать одного агента может оказаться достаточно, чтобы распространить вредоносные инструкции по цепочке. Злоумышленники используют доверие между ИИ-агентами, чтобы добраться до внутренних сервисов и заставить их выполнять несанкционированные запросы.
Атака начинается с вредоносной инструкции, которую один агент получает из содержимого или в ходе выполнения задания. Вместо того чтобы остановить работу, агент может передать текст инструкции следующему участнику цепочки как обычную рабочую задачу.
Независимый специалист по безопасности Сайед Анас Мохиуддин продемонстрировал такие атаки на системах, связанных с Google, JPMorgan Chase, Weaviate, Rapid7, французской межведомственной службой цифровых технологий и федеральным правительством США. Во всех случаях ключевую роль играли уязвимости в механизмах взаимодействия агентов, в том числе через MCP — протокол, позволяющий ИИ-приложениям подключаться к инструментам и обмениваться данными.
Получатель доверяет внутреннему агенту и выполняет команду, хотя при прямом обращении со стороны злоумышленника система могла бы её отклонить. В некоторых сценариях это приводит к SSRF-атаке, при которой сервер под влиянием злоумышленника отправляет запросы к внутренним сетевым ресурсам, недоступным извне. Так можно добраться до закрытых сервисов и чувствительных данных.
Мохиуддин назвал этот класс атак protocol pivoting — «переключение между протоколами»: вредоносная инструкция проходит через одну систему взаимодействия, а затем использует доверие, заложенное в логике другой. Исследователь Маркус Фервье из X41 D-Sec считает, что по сути речь идёт о разновидности промпт-инъекции — внедрения вредоносных инструкций через обрабатываемый системой контент.
Уязвимость в инструменте Rapid7 получила оценку опасности 2,7 из 10 и была исправлена в сентябре. Ошибка в MCP Toolbox for Databases от Google была серьёзнее — 8 из 10: HTTP-клиент мог следовать перенаправлениям на внутренние адреса, не проверяя должным образом целевые IP. Google устранила проблему с помощью списков разрешённых IP-диапазонов и блокировки небезопасных адресов. Эти случаи напоминают о принципе zero trust: даже внутренний агент не должен автоматически получать право выполнять чувствительные операции лишь потому, что запрос пришёл от другого участника сети. Любые передаваемые ИИ инструкции необходимо проверять как потенциально вредоносные.
Подписывайтесь на наш Telegram-канал, чтобы быть в курсе всех новостей и событий Рунета.